
嗨,我是 Nova。大约从 2025 年年中开始,我认真关注起这个问题——起因是我关注的不同社区里反复出现同一种模式:有人用 AI 很快把东西做出来,头两周爽得不行,然后花上一个月去收拾一个自己都看不懂的烂摊子。
听着耳熟吗?
出问题的从来不是那个承诺。缺的从来是结构。
Vibe Coding 的承诺
它为什么吸引了单人开发者
2025 年 2 月,Andrej Karpathy 提出 vibe coding 这个词时,把它描述为一种「彻底跟着感觉走、拥抱指数级增长、甚至忘记代码本身存在」的编程方式。对单人开发者和非程序员来说,这个说法确实让人兴奋:不再有语法焦虑,不再被技术知识挡在门外——只要描述你想要什么,然后看着它出现。
而且它确实有效——至少一开始是。到 2026 年,72% 的开发者日常使用 AI 编程工具,全球 41% 的代码由 AI 生成。Y Combinator 报告称,其 2025 冬季批次中有 25% 的公司跑着 95% 由 AI 生成的代码库。速度上的提升是真实的。
但没有结构的速度不是生产力,只是更快的债务累积。
为什么没有结构,Vibe Coding 必然崩坏
没有计划、没有护栏、没有审查循环
这里有个我花了好久才真正想明白的点。Vibe coding 之所以失败,不是因为 AI 写不好代码,而是因为大多数人在没有任何计划、任何强制规则、任何介于生成与部署之间的审查步骤的情况下使用它。
你在构建中途每改变一次想法,就多欠一点技术债——旧想法的残留还挂在代码里。这些技术债会迷惑以后在这个代码库里工作的 Agent,于是陷入 bug 越来越多的恶性循环。
这个流程感觉像在进步,因为输出一直在出现。但「屏幕上不断冒出东西」不等于「一个能扩展、能维护的可用系统」。
目前,vibe coding 式的 Agent 把你的需求当成「偏好」而非「强制执行的政策」,并不会履行承诺。要保证 Agent 行为可靠,系统必须把规则当作严格规则来执行。
这正是真正的 AI Agent 工作流要填补的缺口。
错误复利问题
CodeRabbit 在 2025 年 12 月对 470 个开源 GitHub PR 的分析发现,由生成式 AI 参与编写的代码,「严重」问题的比例比人类编写的代码高出约 1.7 倍——其中错误配置高出 75%,安全漏洞高出 2.74 倍。
读完这个我立刻想到一个自己反复见到的模式:每个错误都会向下游复利放大。 AI 修好一处,又弄坏另外两处,因为它看不到完整的依赖链。AI 常常意识不到整个代码库的上下文,尤其是在庞大复杂的架构里——Agent 修复了一个文件的 bug,却破坏了引用它的文件,仅仅因为没看到两者之间的联系。
这不是让你停止用 AI 的理由,而是让你建立一种工作流、让这种失效模式在复利放大之前就被抓住的理由。
真正的 AI Agent 工作流长什么样
头脑风暴 → 计划 → 执行:一条结构化链路
从 vibe coding 转向结构化的 AI Agent 工作流,不是要增加官僚流程,而是要在代码出现之前就完成思考。
与其在代码里迭代,不如在计划上迭代。细节在代码里推敲的成本很高——哪怕代码是 Agent 写的也一样。先在一份规划文档里把它们理清。
一个简单且真正有效的结构:
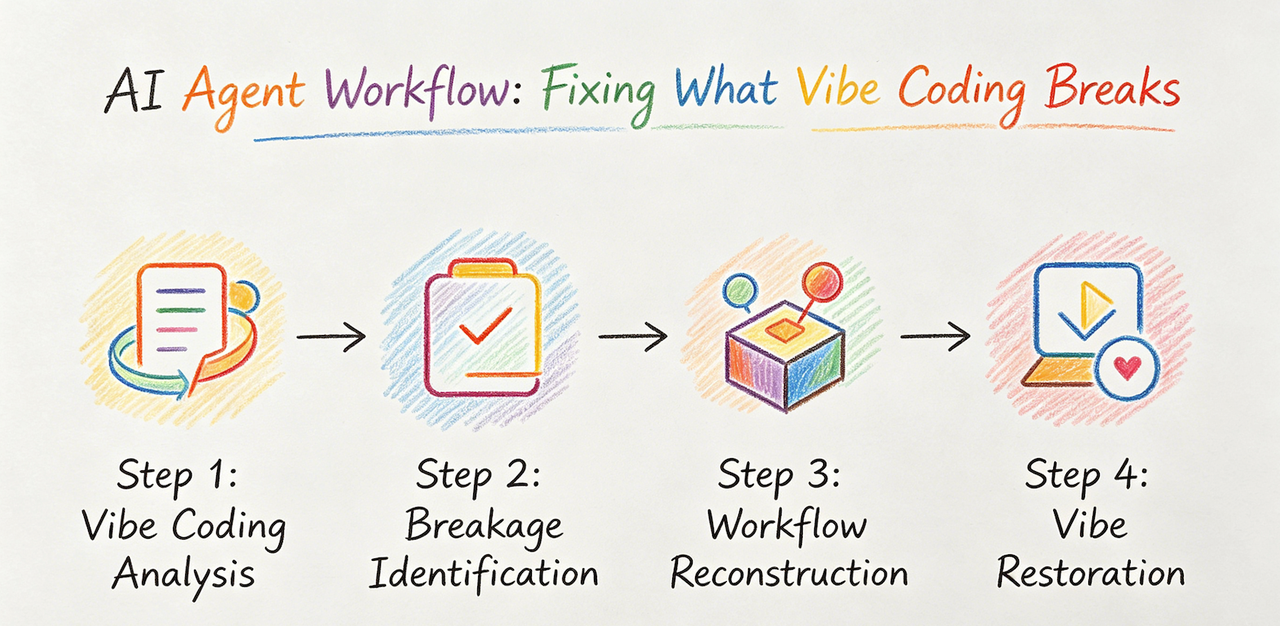
**第 1 步——规格说明。**在碰任何工具之前,先用大白话写一份 spec:这个东西做什么?边界情况有哪些?它绝不该做什么?这份文档就是 AI 要读的东西。它越精确,输出就越精确。
**第 2 步——计划评审。**以「计划模式」把 spec 跑一遍 Agent(Claude Code 原生支持),让它把含糊之处都指出来,在执行之前先修掉。
**第 3 步——有界执行。**一次只给 Agent 一个任务,而不是一整块功能。一次要得太多,它很可能犯迷糊,产出一堆难以拆解的「一团乱麻」——就像 10 个互不沟通的开发者在同时干活。解法是停下来、回退、把问题拆成更小的块。
**第 4 步——验收前先审查输出。**这听起来理所当然,但大多数 vibe coder 恰恰会跳过这一步。
人工检查点该放在哪里
不是处处都放——那反而违背初衷。但至少:在把任何改动合并进 main 之前,以及在任何涉及身份验证、数据处理或外部 API 调用的步骤之后。这些正是最容易出现「幻觉式绕过」——AI 不小心删掉一个安全检查——的地方。
把 AI Agent 工作流当系统,而不是当提示词
为什么结构胜过一次性输出
这是改变我对 AI 编程工具看法的关键重构:目标不是用一条好提示词换来一次好输出,而是要搭建一个每次都能产出稳定、可审查输出的系统。
当 Agent 在约定、结构化规格和确定性流程内工作时,价值才会出现。越来越多的团队开始采用规格驱动开发(SDD):用结构化规格驱动 Agent 产出,取消即兴提示词。
具体来说:你的项目文件夹里应该有一份 AGENTS.md 或 CLAUDE.md 文件,告诉 Agent 你的架构、命名约定、禁用模式与编码标准。它跨会话持续存在,Agent 在累积的上下文之上继续构建,而不是每次都从零开始。
从提示词到可重复执行
把工作流想成一层层结构。最上层是人类决策:做什么、质量线划在哪、审查什么。中间层是 Agent 要读的结构化规格。底层是 Agent 在这些约束之内执行。
2026 年最有力的新兴模式是 Agent 驱动的测试循环:编码 Agent 写代码、生成测试、跑测试、修失败、再迭代——这一切都发生在开 PR 之前。
这个循环只有在 Agent 有东西可以对照测试时才成立。这正是 spec 必须先行一步的原因。
AI Agent 工作流的 GitFlow 模型(AITDD)
把代码审查内建进 Agent 循环
AI 测试驱动开发(AITDD)是许多已经走过 vibe coding 阶段的团队正在采用的模式。逻辑借自 TDD:先写测试,再让 Agent 写出能通过这些测试的代码。
两者结合时,TDD 给你的流程以结构,Agent 式编码给你的结构以速度。这套组合在处理复杂逻辑文件时尤其出彩——定价引擎、基于规则的校验器、或多条件工作流。
实践上:先写一个描述预期行为的、跑不通的测试,然后告诉 Agent「让这个测试通过」。测试就是 spec,测试就是审查机制。你不需要逐行读代码——你只需要知道测试通过了、边界情况覆盖到了。
Kalvium Labs 是一支 200 多名工程师的团队。他们把用 Claude Code 做 pull request 审查标准化,将「到首次提交」的时间缩短了 35–40%;他们强制的「AI Review」流程每周能拦下 2–3 个潜在的生产 bug。
为什么版本管理与迭代很重要
把一切都放进版本控制。每一次改动,注意,每一次。原因不只是为了回滚——而是为了**让 Agent 的决策可审计。**出了问题时(一定会出),你要能精确看到改了什么、何时改的。
GitFlow 模型可以干净地映射过来:每个有界任务一条 feature 分支,PR 充当人类审查检查点,main 分支受保护。Agent 从不直接提交到 main,提交的人是你。
哪些 AI 编程工具能融进这套工作流
Claude Code vs Cursor vs Codex vs OpenCode
这四个工具我都用过一段时间。以下是我对每个工具在结构化工作流里位置的诚实看法——不是把它们当孤立工具。
Claude Code 是你需要在大型、多文件任务里做深度代码库推理时的最强选择。它会读取你的仓库结构、知道你的分支状态、创建带有意义信息的 commit,还能直接开 pull request。hooks 系统让你能强制项目专属规则——lint、测试、格式化——在特定动作前后自动运行。CLAUDE.md 文件对跨会话持久化项目上下文真的很有用。最适合:复杂重构、架构决策、看重上下文深度的项目。
Cursor 是日常交互式编码循环的正确工具。在可视化 IDE 里做日常编码用 Cursor,自主后台任务用 Codex,需要最大上下文的深度多文件工作用 Claude Code。Composer 模式能干净地处理多文件编辑,Tab 自动补全很快。如果你最习惯在编辑器里可视化地工作,Cursor 是更好的日常主力。
**Codex(OpenAI)**擅长异步、定义明确的任务。异步派单——Codex 会起一个沙箱 VM,独立干活,然后交付一个 pull request。最适合常规功能、测试生成和文档工作。在我看来,它在需要执行中反复人工反馈的任务上用处较小。
OpenCode 是开源界的变数。通过 Models.dev 集成,开箱即可连接 75+ 个 LLM 服务商。你可以把不同任务路由到不同模型:便宜快速的模型处理简单问题、推理模型处理架构决策、编程专用模型负责实现。最适合想要最大模型灵活性、不想被厂商锁定的开发者。
说句实话:2026 年我见到的成果最好的开发者,并不对单一工具虔诚。他们用 Cursor 做日常交互,用 Claude Code 做复杂推理任务,用 Codex 做后台执行。
给终端用户的 Gemini CLI 与 GitHub Copilot CLI
如果你整天待在终端里、想要更轻量的工具:GitHub Copilot CLI 能干净利落地根据自然语言生成 shell 命令。Gemini CLI 对 Google 生态用户是个强选项。两者都替代不了一个完整的 Agent 工作流,但作为执行层里的辅助工具都相当合适。
不写代码的单人创业者,怎么用 AI Agent 工作流
开发之外的结构化执行
等等——哪怕你一行代码都不写,这一节也很重要。能防止 vibe coding 灾难的那套结构,同样适用于任何多步骤 AI 工作流:内容管线、调研流程、文档分析、客户交付物生成。
模式完全一致:先写 spec、有界执行、在产出流向任何重要场合之前人工审查。我自己做内容也用它的一个变体:「Agent」是一串结构化的 prompt 链;「测试」是发布前的一份自查清单;「版本控制」是 Notion 文档里一份带日期的简单 changelog。
它不一定要是代码,但它必须是有意为之的。
我关注的一位实践者说得很好:最好的结果,来自把经典软件工程的纪律用在 AI 协作上。先设计再编码、写测试、用版本控制、守住标准——这些东西不仅依然适用,当 AI 写你一半代码时反而更重要。
整件事说白了就是这样:Vibe 依然欢迎,护栏只是让它们更持久。
上一篇:
→ 了解为什么 vibe coding 没有结构就会崩坏,以及用什么替代它
→ 了解 AI Agent 对单人创业者到底怎么工作(不只是提示词)
→ 学会怎么 构建可重复的 AI 工作流,而不是一次性输出
→ 探索从 聊天式 AI 到持久化、有状态的 Agent 的转变
常见问题
AI Agent 工作流比 Vibe Coding 更好吗?
Vibe Coding 没有结构,到底会坏在哪?
一套结构化的 AI Agent 工作流实际怎么跑?
用这套工作流需要会写代码吗?
不写代码的单人创业者也能用吗?
应该从哪些工具开始?
https://floatboat.ai/zh/blog/ai-agent-workflow-vibe-coding