
GPT Image 2 漫画创作实战:单人创作者的全章工作流
GPT Image 2 能渲染可读的 CJK 文字并保持跨格角色一致性——本文用一次四页日漫测试讲清单人日漫/美漫创作者如何搭建整章工作流:角色一致性、对白气泡、SFX、场景背景衔接的做法与局限,以及每周产出 30+ 格的资产管理。

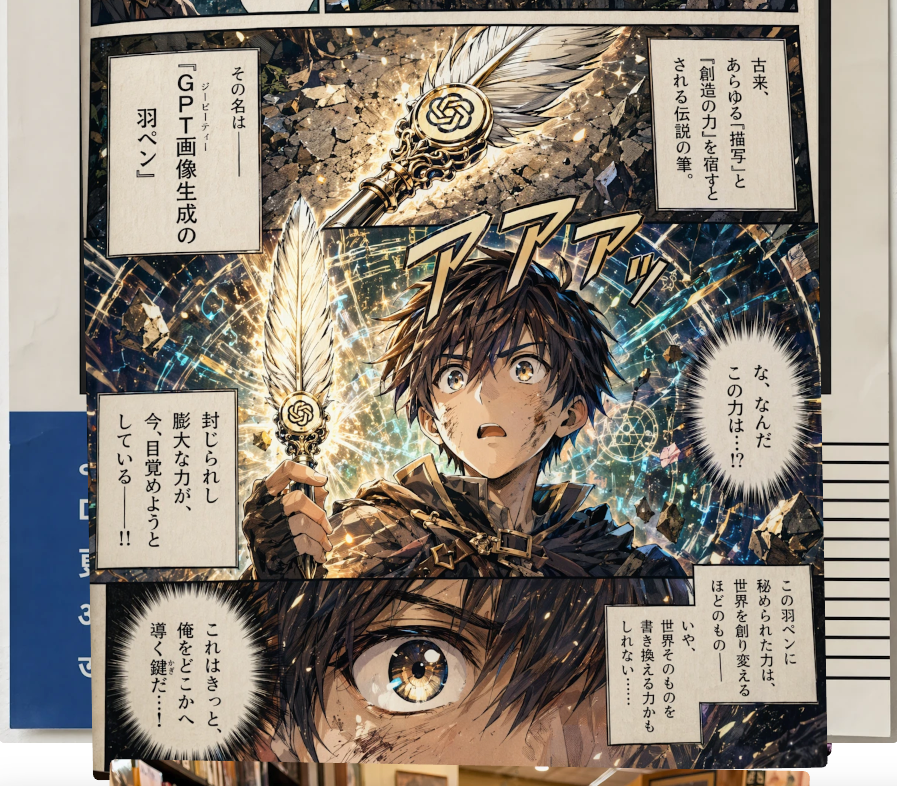
你好,我是 Nova。上个周末我用 GPT Image 2跑了一个四页日漫测试。不是演示,不是单张分镜——而是一段真实的短场景:同一个角色、日文对白气泡、SFX、外加几个需要让人感觉"是同一个地方"的背景镜头。
我进场时是怀疑的。我搞小型漫画实验已经一年左右,以往每个模型都在第二格到第三格之间的某个地方崩掉——通常是脸,有时是汉字。所以我没抱太大期望。
话说回来——这不是在说"AI 取代了你的漫画工作流"。更像是一个具体的瓶颈变小了,同时又冒出来几个新瓶颈。下面是我实际学到的东西。
GPT Image 2 里对漫画创作者要紧的变化
CJK + 拉丁文本渲染,准确率接近完美
这是头条级变化,而这一次头条与体验相符。根据 OpenAI 官方对 ChatGPT Images 2.0 的发布说明,这个模型是为"复杂视觉任务"打造的,文本渲染是核心升级之一。独立测试把拉丁、中文、日文、韩文、印地语和孟加拉语的字符级准确率定在约 99%——VentureBeat 的上手评测还专门点名日漫对白气泡是"看起来天衣无缝"的东西之一。
以前,我要先生成一格,用 Photoshop 把气泡抠掉,再亲手写汉字。对标题级长度的文字,这一步现在基本省了。**但小字号的大段密集文字,它仍会出错。**我把气泡内文字控制在每行 15 个字符以内,就稳得住。
多轮编辑,不必从头重新生成
另一个变化是对话式编辑。你先生成一格,然后说"保持其他不变,重画她的表情——她现在低头看,脸上阴影更多"。模型只编辑_那个部分_,而不是整张图。画面其余部分——姿势、背景、光照——保持不动。
这听起来很小。其实一点都不小。**旧工作流是:重生成二十次,盼着哪次足够接近。新工作流是:生成一次,然后做外科手术式的迭代。**我以前把大部分时间花在跟模型搏斗上;现在大部分时间花在指挥它上。
4K 分辨率,以及对印刷的真正意义
GPT Image 2 支持最高 4K(4096×4096)输出。Microsoft 的 Foundry 文档确认了分辨率档位和灵活的长宽比——这有用,因为漫画分镜很少想要正方形。300dpi 印刷时,4K 大约能让你不放大就得到半页分镜;要求不高的话,一整页 splash 也够。对数字端——webtoon、Instagram、你自己的网站——则是"好得过头"的那种强。
一套现实的单人漫画工作流,一步步来
从剧本到分镜 prompt
我先把这一页写出来。只写剧本——对白、SFX、发生了什么。然后给每一格构建一个分四部分的 prompt,每次都一样:
-
场景——在哪里、何时、天气、光线
-
角色——跨格逐字复用的同一段描述
-
风格——黑白日漫、网点、线条粗细
-
构图——全景 / 特写 / 过肩,文字放在哪
重复很重要。角色描述必须跨格完全一致。不是换种说法。是完全一致。"短深色头发、雀斑、超大号奶油色毛衣。"同一串字符。每一格都用。我第一次试的时候偷了懒——觉得逐格复制粘贴很冗余,就每格换了点措辞——结果五格里角色的鼻子变了三次。用最笨的方式学到了教训。
对我来说,一个能用的四格 prompt 大概长这样:顶部放同一个场景锚点,同一个角色字符串重复四次,然后四行短句只描述变化的东西——机位、表情、画面里有什么。任何我想让它作为画面内字面文字呈现的内容,都放进 "双引号" 里。省略引号,你得到的就是"看起来像模像样的乱码"。
让角色设计贯穿一整章保持一致
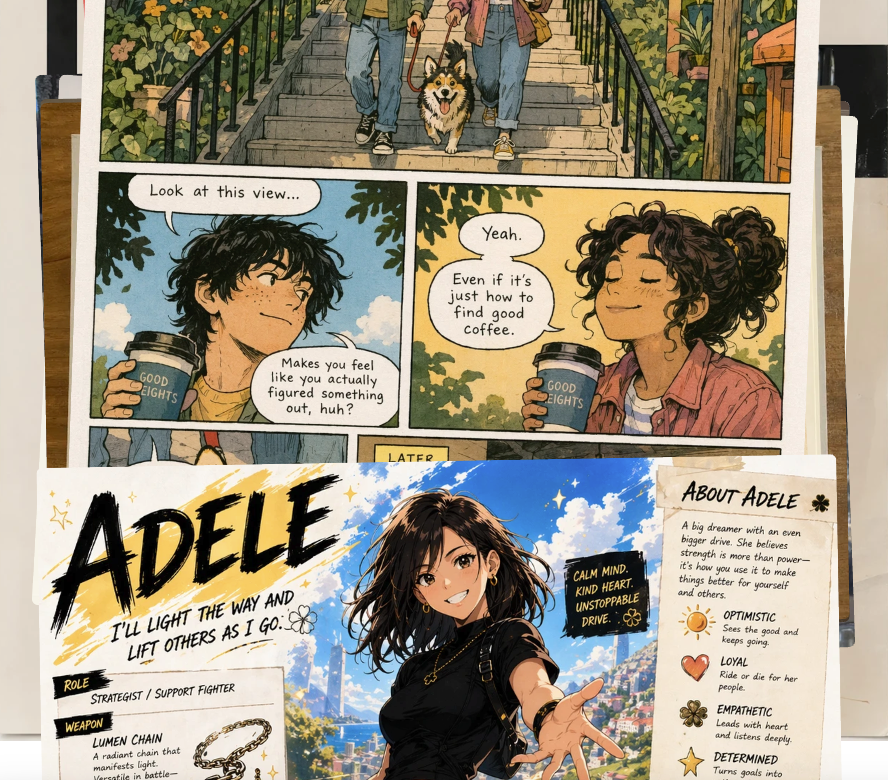
这是开始变得有意思的地方,也是我学会管理预期的地方。据 The New Stack 对这次发布的报道,Thinking 模式专门设计用于跨多帧维持角色与物体的一致性——漫画与分镜被明确点名。
实践中,开着 Thinking 模式、用单个 prompt 生成 8 格一批,我能让其中大约 5–6 格保持可辨认的连贯性。其余 2–3 格的脸需要小幅重抽。相比逐格生成——一致性基本靠抛硬币——这是巨大的进步。
对更长的序列,我会留一张"角色参考页"——角色在不同角度的三格成功样例——并把它们作为图像输入喂回给新分镜。这是我目前最接近"真正的角色锁定"的东西。
对白气泡、SFX 与混排文字排版
把确切的文字放进双引号。这不是风格选择,而是模型解析字面字符串的方式。没加引号的文字会漂移;加了引号的文字会照实渲染。
所以:分镜中包含一个想法气泡,内容为"彼が帰ってきた",角落里有一个读作"ザワザワ"的 SFX。
一个气泡里的混排文字——比如英文外加一小句日文旁注——比我预期的更常成功,但我仍然会放大检查每一格。密集段落仍偶尔会换掉一笔一画。
迭代分镜而不破坏构图
一旦一格做到 80%,我就停止重生成,开始编辑。"保持一切不变;把眼睛下方的阴影柔化一点"——这类指令。对话式编辑模式会保留画面的其余部分。对我来说,这是最大的工作流变化,也是让单人量产从"一个月"变成"一个周末内现实可行"的东西。
GPT Image 2 仍然会崩的地方
我想在这里保持诚实,因为发布报道大多一片欢腾,而那并非全貌。
长序列中的脸与手
即便有很强的 prompt,脸在约 6–8 格之后也会漂移。不算剧烈——但足够让细心的读者在第 9 格发现她的鼻子有点不一样。动态姿势下的手(拿东西、指东西)大约每四格仍会错一次。手我手动修。每一页都修。
格与格之间的背景连贯性
如果第 1 格是咖啡馆内景,第 3 格是同一家咖啡馆的另一个角度,模型给你的是一个_合理的_同一家咖啡馆——同样的氛围、大体同样的布局——但椅子数变了、窗户位置挪了、后墙的菜单板写着不一样的字。对交代场景的定场镜头来说没问题;对需要严格连贯性的镜头(角色从 A 桌走到 B 桌),它就散了。
我的对策:先生成定场镜头,然后把它当作该场景内其他每一格的图像参考。
一整章内的风格漂移
跨 20+ 格之后,线条粗细和网点密度会漂移。到第 25 格,风格已经微妙地比第 1 格更柔和。DataCamp 的评测指出,这个模型的定位是"视觉思考伙伴",而不是固定风格的渲染器——我觉得这个框定对它擅长什么、不擅长什么,其实说得很诚实。
模型撞墙时怎么办
当一格怎么都生成不对时,放弃之前我有三个后备方案。
**一:丢一张参考页。**把角色的三格好样例作为图像输入放进去,重新 prompt。命中率明显上升。
**二:在任意图像编辑器里修手和小字。**我用的是一个免费工具。模型能带你到 90%;最后那 10% 仍然是人的活——假装不是,你就会做出主角有八根手指的漫画。
**三:对于需要反复出现的背景,一次以 4K 生成背景、存下来,然后把角色合成上去,用于该场景其余的分格。**这是老式漫画制作技术套用到 AI 输出上,而且有效。
每周产出 30+ 格时,怎么处理资产泛滥
这是没人提醒你的部分。按我的工作流,单单一章现在会生成大约 60–80 个图像文件(草稿加定稿)——参考页、分镜迭代、背景底板、修好的版本。三章之后,我的文件夹里有 250 多个未分类的 PNG,什么都找不到。
我最后建了一套基本命名规范——ch02_p04_panel3_v2.png——外加每章一层扁平文件夹结构。无聊,但它是"能交付"和"交付不了"的区别。单人创作者的瓶颈不再是生成。它变成了文件管理。
这套工作流适合谁,谁该跳过
我是这么看的。如果你是做短篇叙事连环画的单人创作者——网络条漫、四格漫画、韩漫短篇、给自己视频项目做的分镜——这真的有用。它不是技能的替代品,但能在你本来就不享受的部分(背景、文字排印、基础场景调度)上省下真实的时间。
如果你受过传统漫画训练、有强烈的个人风格,风格漂移会让你沮丧。模型给你的是"某种"日漫观感,不是"你的"日漫观感。这个差距是真实的。
如果你想做一部要求严格连贯性的长篇连载作品,超过 8 格的角色一致性限制、场景之间的背景漂移,会让它感觉更像一场搏斗而不是一个工具。值得再等一个版本周期。
对介于两者之间的所有人——好奇的、为了好玩在做的、想试试自己能不能交付一部 12 页短篇的——值得花一个周末。价格合理:包含在 ChatGPT Plus 每月 20 美元的标准档里(带用量限制),或者做生产用途可以走 OpenAI API 模型页的按 token 计费。API 上图像输出 token 大约每百万 30 美元,按我用的分辨率算下来每格只要几美分。我写这篇文章时核对过文档;投入之前请再验证——API 档位 5 月初向所有开发者开放。
这就是我目前的进展。把它存下来,找一页短的试试,感受一下它在你手里是什么手感。模型会不断变化——今天为真的,三个月后未必为真。但有一件具体的事——带清晰 CJK 文字的单人叙事漫画——它刚刚跨过了一道值得你知道的门槛。
回去画画了。
延伸阅读
常见问题
它真能把气泡里的文字渲染清楚吗?
它能保证同一角色跨整章一致吗?
它适合韩漫(manhwa)或竖屏 webtoon 吗?
能用于商业作品吗?
它会取代真正的画师吗?
现在完成一页比以前快多少?要花多少钱?
https://floatboat.ai/zh/blog/gpt-image-2-manga-comic-workflow