OpenAI GPT-6 Cyber 开始限量开放,安全团队能用它做什么?
OpenAI 开始向部分 Daybreak Red 客户开放 GPT-6 Cyber,用于经授权的漏洞研究与安全测试。本文说明谁能获得访问权、API 如何计费、怎样读懂 Critical 评级与基准成绩,并用预发布环境的权限回归说明如何验证补丁。
Kostja1 分钟阅读
本分类共 22 篇文章。
OpenAI 开始向部分 Daybreak Red 客户开放 GPT-6 Cyber,用于经授权的漏洞研究与安全测试。本文说明谁能获得访问权、API 如何计费、怎样读懂 Critical 评级与基准成绩,并用预发布环境的权限回归说明如何验证补丁。
GPT-6.1 Sol 以 Astra 五分之一的标准 token 价格,提供接近 Astra 的编程、电脑操作与专业工作能力。本文解释这些数字真正意味着什么。
Jev 是 TypeSafe AI 发布的 System One 模型:读取状态、返回带置信度的 typed decisions,而不生成任何文本。本文拆解其 RLCD 训练方法、官方宣称的 193.6x 加速与 444.6x 成本优势,以及 Hacker News…
DeepSeek V4.1 Flash 已成为正式 Flash 模型。本文核对生产模型名、1M 上下文、视觉能力、峰谷价格、退役别名、V4 Pro 临时路由,以及从限时测试版迁移时必须复测的关键项目。
基于 OpenAI 当前官方资料解释 GPT-6 Astra:10/50 美元价格、1.05M 上下文、工具支持、长上下文溢价、Critical 网络安全门槛,以及与 GPT-6.1 Sol、GPT-6 Luna 的选型边界。
解释 Gemini 3.8 Flash 相比 3.7 的真实变化,覆盖准确 ID、1M 上下文、thinking level、限时价格、工具行为、token 代价、版本限制与可复现任务路由测试。
把 MiniMax H3 Max Live 作为实验性连续视频管线评估,覆盖官方状态、价格、吞吐、缓冲、审核与成本测试,核验于 2026 年 10 月 13 日。
DeepSeek Harness 是 DeepSeek 官方打造的 AI 编码 Agent——连接 V4 模型与真实软件工程工作的执行层。本文解析 Model + Harness = Agent 的核心定义、架构来源与招聘信息透露的设计方向、V4-Flash 0731…
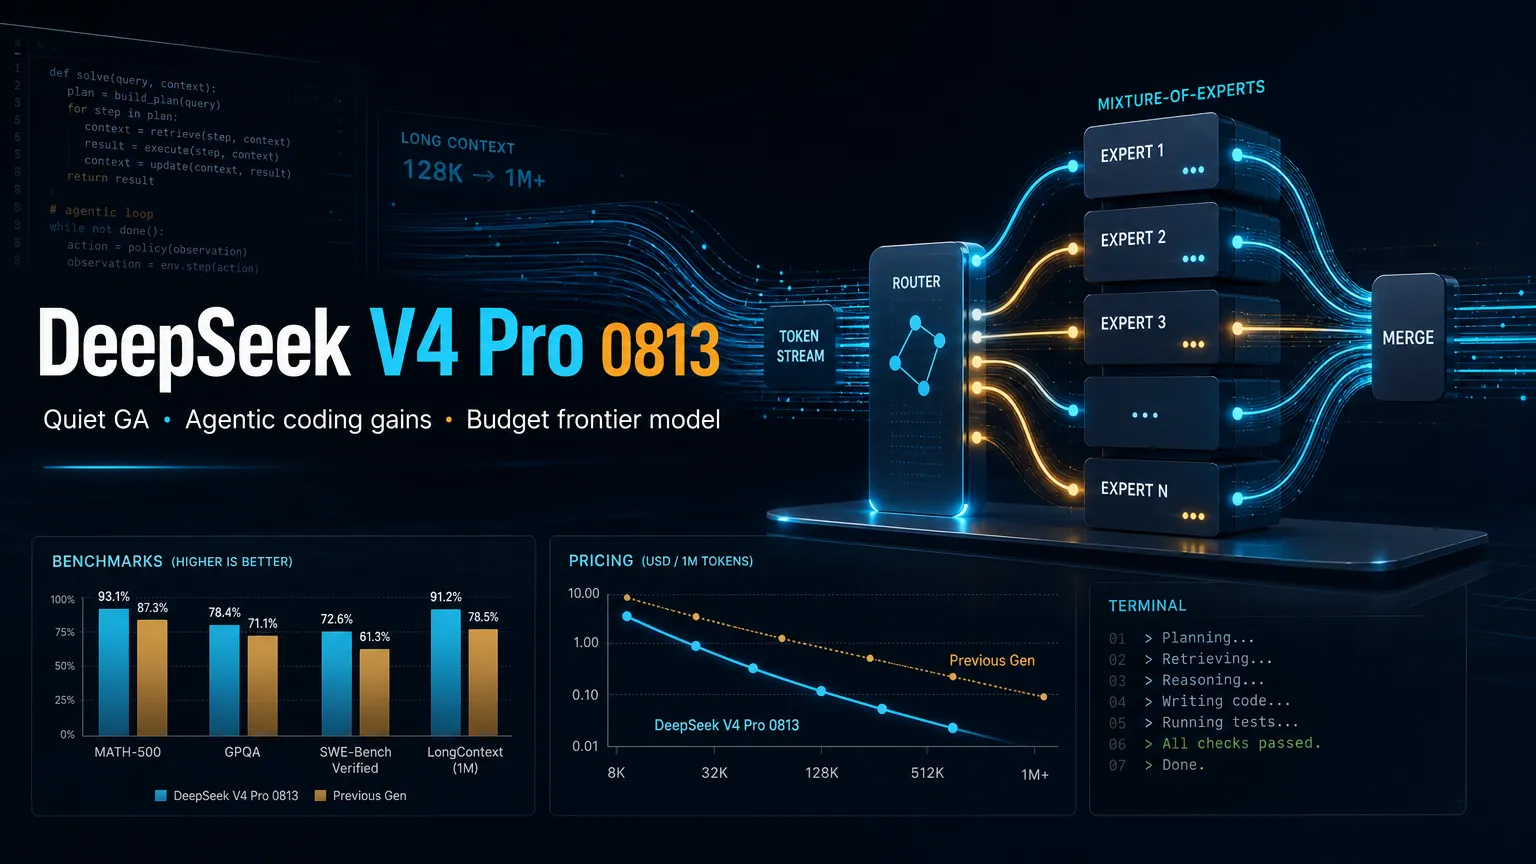
DeepSeek V4 Pro 0813 在没有发布公告的情况下悄悄转正(GA)。本文整理其完整规格、官方声称的 Agent 基准成绩、8 月 16 日涨价前的定价窗口、与预览版相比的真实变化,以及它与同周发布的 Grok 4.6 的正面较量。
在比较 GLM-5.3 托管 API 与 Coding Plan 前,先核验权重工件是否可下载、许可证条款与自托管要求,并评估 thinking 参数迁移、Agent 适配、基础设施成本及每个合格任务的总成本。
基于官方资料与独立评测解析 Grok 4.6:50 万 token 上下文、推理档位、API 价格、长上下文成本与基准版本差异,并说明 Grok 4.7 发布后哪些场景仍值得保留 4.6。
MiniMax H3 是开放权重的全模态视频系统,可统一处理文本、图片、视频与音频并生成原生立体声音视频。本文核对 FL2VA、Ref2VA、输出规格、完整价格、开放权重边界与统一素材测试方法。
从开放权重边界、Kimi K3 License、准确 kimi-k3 API ID、1M 上下文、当前多币种价格、工具兼容、64+ 加速卡建议与自托管总成本解析 Kimi K3。
按当前 API 价格、长上下文溢价、推理档位、工具支持和真实工作负载,对比 GPT-5.6 Sol、Terra 与 Luna,并区分发布预览价、后续调价和 GPT-6 上线后的选型位置。
按任务风险、等待成本、复核难度与预算,选择 AI 推理投入和响应速度的实用框架,并用可复现评测判断何时提高 Effort、何时值得使用 Fast Mode,以及如何避免为无效的深度推理与速度溢价买单。
Gemini 3.5 Flash 仍是稳定模型,但已不是 Google 最新的 Flash。本文核对其能力、成本、隐私和工具边界,并用可复现工作流判断单人经营者是否仍值得集成。
Muse Spark 到 1.3 版本发生了什么变化,一人公司应如何评估多模态、Agent 与编码能力、接入方式、复核负担和迁移成本,并通过窄路径测试决定是否切换。
一套可核验的 GPT Image 2 漫画工作流:从脚本拆格、角色与场景设定、逐格生成,到独立排字、连续性审校、版权核对、成本记录与印刷导出,并用六格试刊判断这套方法是否值得扩展到整章制作。
GPT Image 2 能独立产出可用的影视或短视频分镜吗?一位单人创作者实测 24 帧短片分镜,本文讲清它擅长什么、在哪里翻车,以及何时该请真人分镜师、何时用 GPT Image 2 就够了。
面向一人公司的 GPT-6 Astra 实用指南:适合哪些真实业务任务、如何计算每项工作成本、怎样控制工具权限、如何设计采用前评测,以及哪些工作应交给更便宜的模型或确定性自动化。
Grok 3 API 已在 2026 年退役,旧 slug 会自动转到 Grok 4.3。本文说明实际计费、现行模型选择、搜索工具成本,以及小团队如何安全迁移。
面向单人经营者的 DeepSeek V4 API 当前指南:核对模型 ID、峰谷价格、缓存经济性和路由变化,并用每个验收任务成本、预算上限与人工审核设计一轮可控试点。
/zh/blog/category/model-benchmarks