单人创始人的角色化 AI 工作流:gstack 方法真正说对的地方
gstack 在开发者圈爆火——但真正的洞见与编码无关。Nova 拆解:为什么给 AI 一个清晰的角色(研究分析师、策略师、写手分开干)会改变一人公司的产出质量、认知科学依据与它的边界。
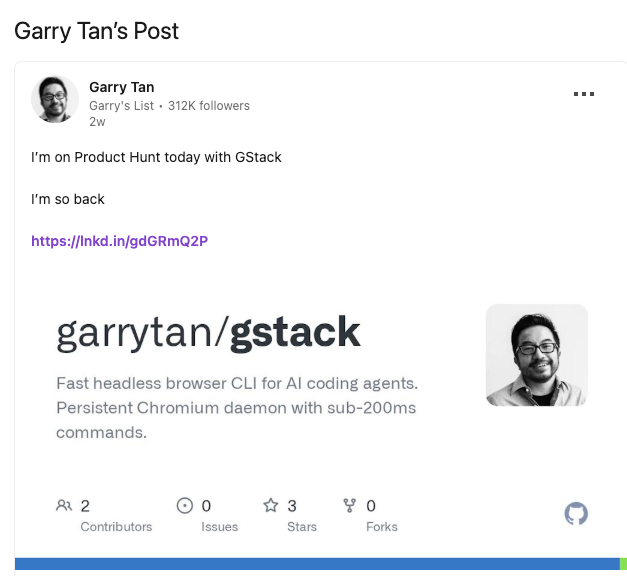
嗨,我是 Nova。我和大多数非开发者一样偶然撞见 gstack——在应该赶交付物的时候刷 X,看到有人转发了 Garry Tan 在 GitHub 上的发布。这个仓库 48 小时内拿到 10,000 颗星,成为 2026 年 GitHub 上增长最快的开发者工具之一。我不是开发者。我差点继续往下刷。
然后我读到了它到底是什么——停住了。
**这篇文章不是把 gstack 当作编码工具来谈。**它讲的是底层的工作流逻辑,适用于任何一天内要扮演多个认知角色的人。我会讲讲角色化 AI 提示意味着什么、研究怎么说它为什么有效、我自己工作流里一个具体的前后对照,以及它的边界在哪里。
gstack 到底是什么——以及为什么这个想法比代码更大
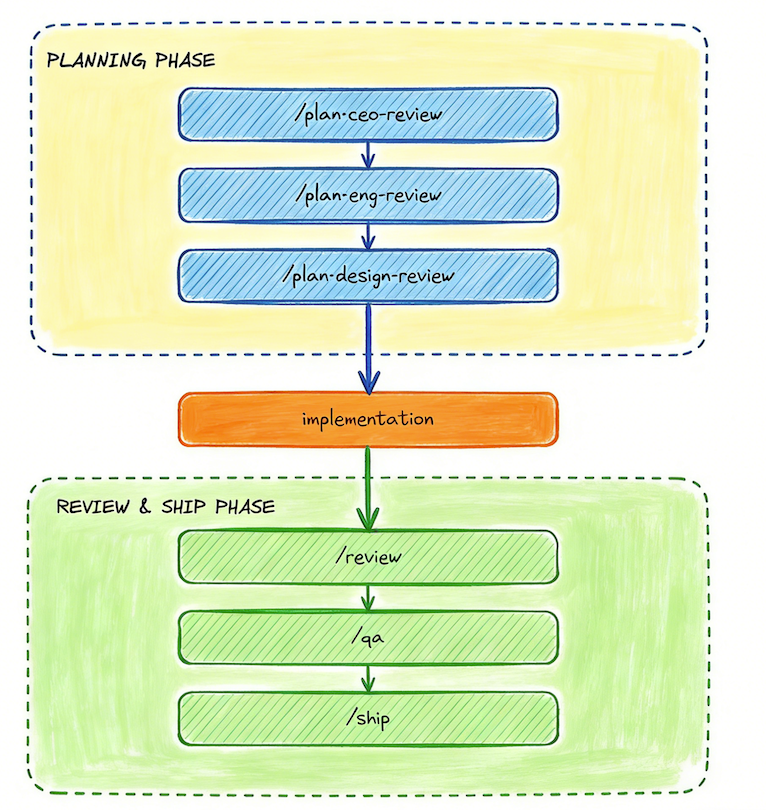
gstack 是 Garry Tan 为Claude Code打造的开源技能包。Garry Tan 是 Y Combinator 的总裁兼 CEO。它把一个 AI 助手改造成一支结构化的专家团队:一个做产品评审的 CEO 角色、一个锁定架构的工程经理角色、一个会打开真实浏览器点来点去的 QA 工程师、一个管文档的发布经理。每个角色都作为一条斜杠命令运行。
Tan 公开分享的吞吐数字很惊人:用这套配置,他在 50 天里平均每周产出约 10,000 行代码和 100 个 pull request——大约 60 万行生产代码,其中 35% 是测试。(TechCrunch 在报道里指出,社区反应褒贬不一——有人觉得真有用,有人称之为"不过是提示词"。两种反应都说得通。)
背后的哲学是:**大多数人把 AI 当作万用工具,在同一个上下文里塞给它含糊的多任务指令。结果就是没有重点的产出,缺了真实团队能交付的那种深度。**gstack 的答案是他们所称的"认知分档(cognitive gearing)"——逼着模型进入不同角色,让它没法在任务中途来回切换上下文。
等等……这个想法不只是给开发者用的。
角色化提示真正在解决的问题
这是我读完那篇帖子之后一直在琢磨的事。
我经营一人内容业务。没有开发团队、没有经理——只有我,做研究、写作、做产品决策、处理一切冒出来的事。而且经常挤在同一个两小时里。
大多数 AI 用户干的是同一件事。打开一个聊天,输入当下需要的东西,处于什么模式就输入什么:帮我写这封邮件。现在帮我想想 Q2 策略。现在总结一下这个竞品网站。现在帮我算算定价。 AI 顺从地跟着你切换。但产出有点浅。它做了你要求的——只是没有站在正确的心智位置上做。
研究支持这一点。 MIT Sloan 关于 AI 与知识型员工的研究里一项 2025 年研究发现,使用 AI 的顾问在每一步都保持"认知付出与专家判断"时表现最好——研究者称之为像"半人马(centaurs)"一样运作,刻意在 AI 和自己之间划分任务。让 AI 在没有角色边界的情况下包办一切的员工,即便文字看起来漂亮,产出推理的质量也往往更低。
问题不在 AI。在于没有人告诉它该进入哪个角色。
前后对照:同一个研究任务,两种做法
说点具体的,因为关键就在这里——要么你一下就懂了,要么不懂。
**场景:**我在评估一个新的内容方向值不值得投入。我需要研究竞品定位,然后找角度,然后写一版开头的草稿。
**老办法:**开一个标签页,拉出竞品内容,粘进 Claude,问含糊的问题,然后中途转向"现在帮我写开头"。输出在技术上没问题——句子通顺、结构合理。但我看着它总觉得哪里不对。研究没有真正的锋芒。开头听起来跟这个领域里其他所有开头一样。
发生了什么:我在让模型同时扮演"分析师、策略师、写手"——平均化的输出。三样都及格,一样都不出色。
角色化版本长这样:
_第一阶段——研究分析师:在我输入任何东西之前,我先显式设定框架:"现在你处于研究分析师模式。你唯一的任务是找出竞品行为里的模式,并标记出我可能正在做的假设。先不要生成内容或给建议。"_我粘进竞品例子。它抛出三件我没注意到的点。其中一个真的有用。
_第二阶段——内容策略师:新的会话,新的角色:"这是研究得出的内容。现在你处于内容策略师模式。值得追的角度是什么,为什么?"_输出更锋利了——因为模型没有在同时试着写正文。
_第三阶段——写手:_到这一步我才要草稿,并显式把第二阶段的那个角度交给它。
同一个 AI。同一份信息。研究阶段多花了大约 8 分钟。但总修改时间大幅下降——我大概只重写了 20% 的草稿,而不是通常的 60–70%。
我没法给你一个受控实验。但过去三周我一直在稳定地跑这套模式,重写比例一直维持住。这对我来说足够继续做下去了。
为什么有效:角色分配背后的认知科学
角色边界能提升 AI 产出,有一个真实的理由——不只是安慰剂效应。
圣路易斯联储总结近期 AI 生产率研究的文章发现,每天用 AI 的员工平均省下 5.4% 的工作时间——40 小时工作周里大约每周 2.2 小时。但收益分布并不均匀。把 AI 整合进结构化、任务特定工作流的员工,时间节省最多——而不是把它当通用聊天工具用的那批人。
机制在于:**当你给语言模型一个范围清晰的受约束角色时,你就降低了"什么算好产出"的模糊性。**模型不是在同时满足多个目标。它在优化一件事——你此刻真正需要的那件事。
这跟系统提示词不同。系统提示词设定一般的行为和语气。角色化框架走得更远——它定义模型该优先什么、该忽略什么、以及对_这一步_来说什么算成功。"要有帮助"和"你是一名研究分析师,你的工作是暴露数据里的矛盾,而不是解决它们"——差别就在这里。
一个值得点出的保留:关于角色提示的研究结论并不一致。Sander Schulhoff 2025 年那份综合性的提示技术分析——基于他与 OpenAI、Microsoft、Google、Princeton、Stanford 研究者合著的一篇综述——发现"你是一位数学教授"这类简单角色提示对准确率几乎没影响。重要的不是标签——是你绑在角色上的约束和范围。"你是一名研究分析师"什么用都没有。"你是一名研究分析师。你的唯一产出应该是模式和标记出的假设,不是建议,也不是成段文字"——这才不同。
角色化 AI 在哪里失效
关于局限我想诚实一点,因为我觉得有些 gstack 的报道把这些问题一笔带过了。
**当你的任务定义清晰时,角色分配很有效。**当你知道自己处于研究模式或编辑模式,分配角色又快又真的有用。
但有一类真实的工作——那些"搞清楚你到底想解决什么问题"的混乱中间地带——过早强加角色反而会收窄你的思路。我有过这样的会话:分配了分析师角色,得到一个非常自洽的回答,然后发现自己问的根本是错的问题。角色没能帮我察觉这一点。
**另一个真实的限制是记忆。**gstack 的虚拟团队跨会话没有共享上下文。CEO 角色周二的洞见,到周三就没了。对跑单一专注项目的开发者来说,这可控。对同时跑四条工作流的单人运营者来说,这是真实的摩擦。每个会话都要重新建立"谁知道什么"。
这其实是 AI 工作区工具变得相关的地方——不是作为角色化提示的替代品,而是作为一层跨会话保持上下文的载体。Floatboat 通过他们所称的 "Tacit Engine" 来接近这个目标——理念是工作区会随时间从你真实的工作模式里学习,让角色分配得以延续而不是每次重置。我用了它几周。它还不是一个完成品,我也还在琢磨怎么在不制造太多额外负担的前提下组织我的工作流。但底层逻辑——角色化提示在 AI 已经了解你上下文的时候会更强大——这部分我觉得说得通。
一个实用框架:不懂开发也能用
下面是我把 gstack 的逻辑转译成非代码工作流的方法。三步,不需要 CLI。
**第一步:在开始输入前,先说出当前的认知模式。**每次 AI 会话前,写一句话:"现在我处于 [X] 模式。你的任务是 [具体产出]。不要 [要避免的事]。" "不要"那部分和其余部分一样重要。
**第二步:把不同阶段拆到不同会话里。**别让研究、策略和执行共享一个上下文窗口。每个阶段都有自己的开场框架。一开始会感觉更慢。其实不会——它砍掉的是修改时间。
**第三步:把产出存档往前带。**每个会话结束时,存一份 3–5 句的摘要,记下你发现了什么、决定了什么。下一个会话开始时把它粘进去当上下文。这是手动记忆,但有用。
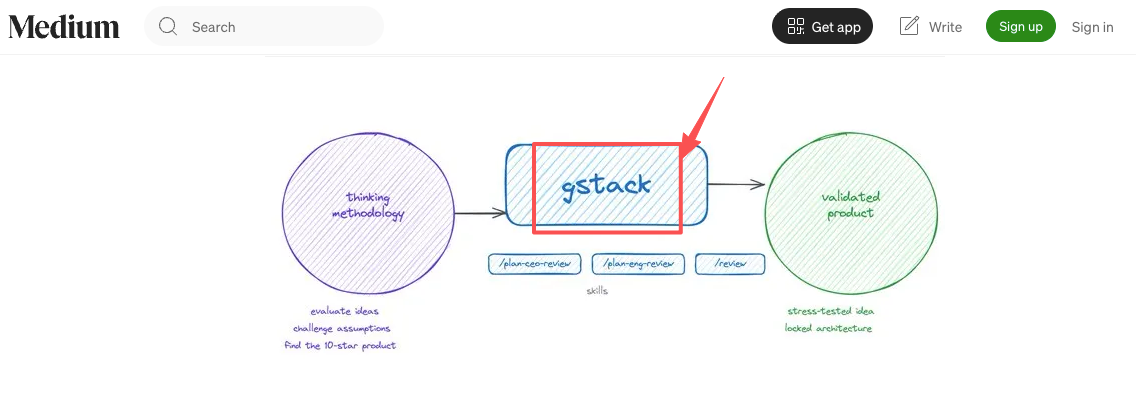
总之,这是我把这套方法跑了三周后得出的结论。gstack 这套开发者的外壳对程序员来说确实有意思。而底下那个想法——当 AI 知道自己戴的是哪顶帽子时会更锋利——适用于任何独自做复杂工作的人。我还在琢磨细节。但这个基本模式已经留下来了。
回去继续干活了。
上一篇系列文章:
常见问题
用角色化提示需要懂开发吗?
这不就是写个更好的提示词吗?
如果我不知道该用哪个角色怎么办?
这对创意工作也适用吗?
这和每个任务用独立工具有什么不同?
我设的角色能跨会话延续吗?
https://floatboat.ai/zh/blog/what-gstack-gets-right-about-one-person-businesses