
什么是 LLM Wiki——你该不该建一个?
Karpathy 的 LLM wiki 爆火是有原因的。它到底是什么、为谁而建、单人创业者需不需要一个?本文讲清「预编译知识库 vs RAG 每次重来」的核心差异,拆解 Farzapedia 这类真实案例,并给出不建任何基础设施也能用的变体。
嗨,我是 Nova。说实话,几周前Karpathy那条推文开始刷屏时,我的第一反应是「等等,这真的是新东西吗?」我捣鼓个人知识体系已经有一阵子了——Obsidian 库、自定义 GPT 指令、各种笔记倾倒式工作流。我知道 RAG 是什么。所以第一次扫到关于他那份 LLM wiki 的帖子时,我差点直接划过去。
然后我真的读了那份 gist。
好吧。我懂它为什么爆火了。
LLM wiki 是什么——大白话版
先把术语剥掉,因为这个概念一旦看明白,真的很简单。
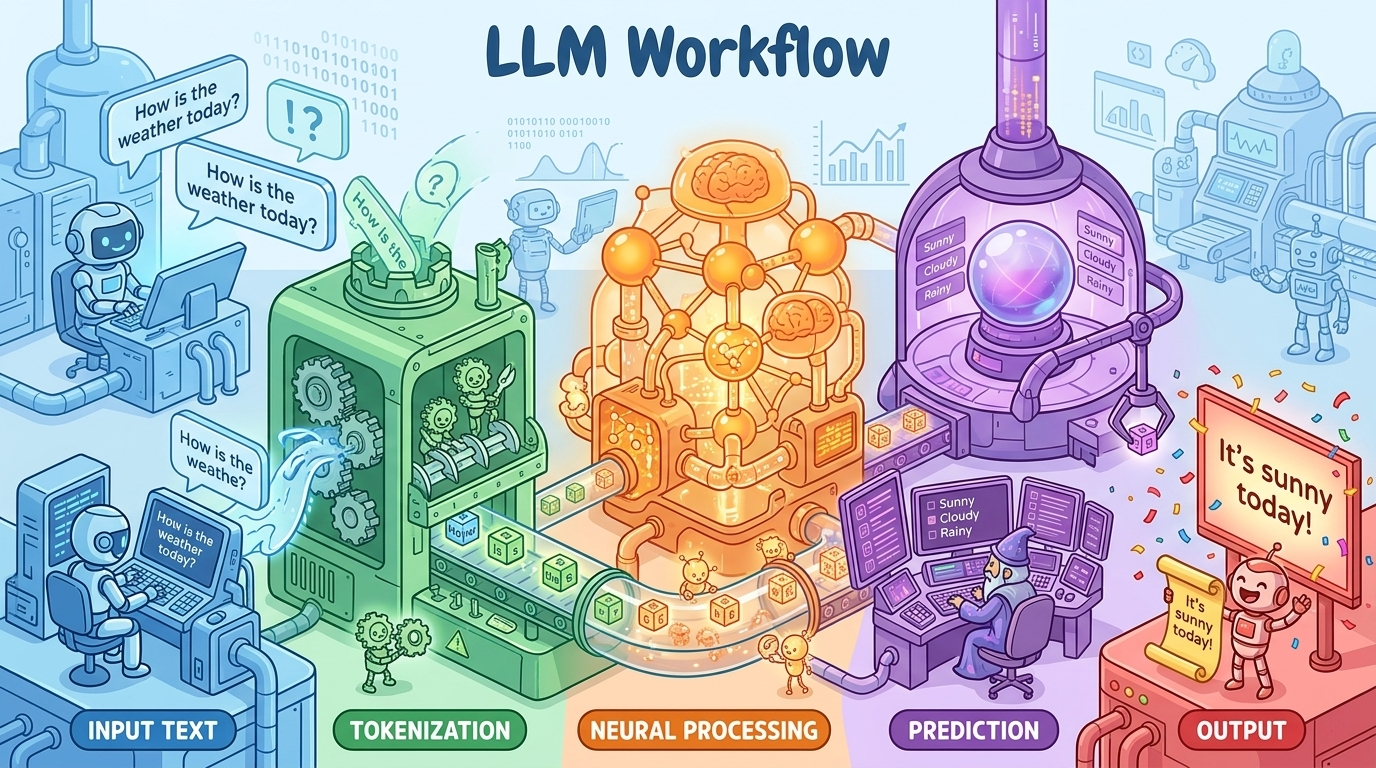
我们大多数人这样使用 AI 与文档:上传一份 PDF 或贴进一些笔记,问一个问题,AI 找到相关片段、生成一个回答。这就是 RAG——检索增强生成(Retrieval-Augmented Generation)。它有效,但有一个致命缺陷:**每一次提问都从零开始。**AI 不会在多次提问之间积累知识,它每一次都在重新发现。
LLM wiki 把这件事翻了过来。不是即时检索原始文档,而是让 LLM _预编译_你的素材,编成一份结构化的 wiki——一个相互链接的 markdown 文件目录。之后你再提问,AI 不再去翻原始 PDF,而是在一个已经综合过它们的知识库里导航。
正如 Karpathy 在原始 gist里所说:「用 RAG,你每次饿了都要现做菜。用 LLM Wiki,你建一间会不断改良自己食谱的厨房。」
这个比喻让我记住了。
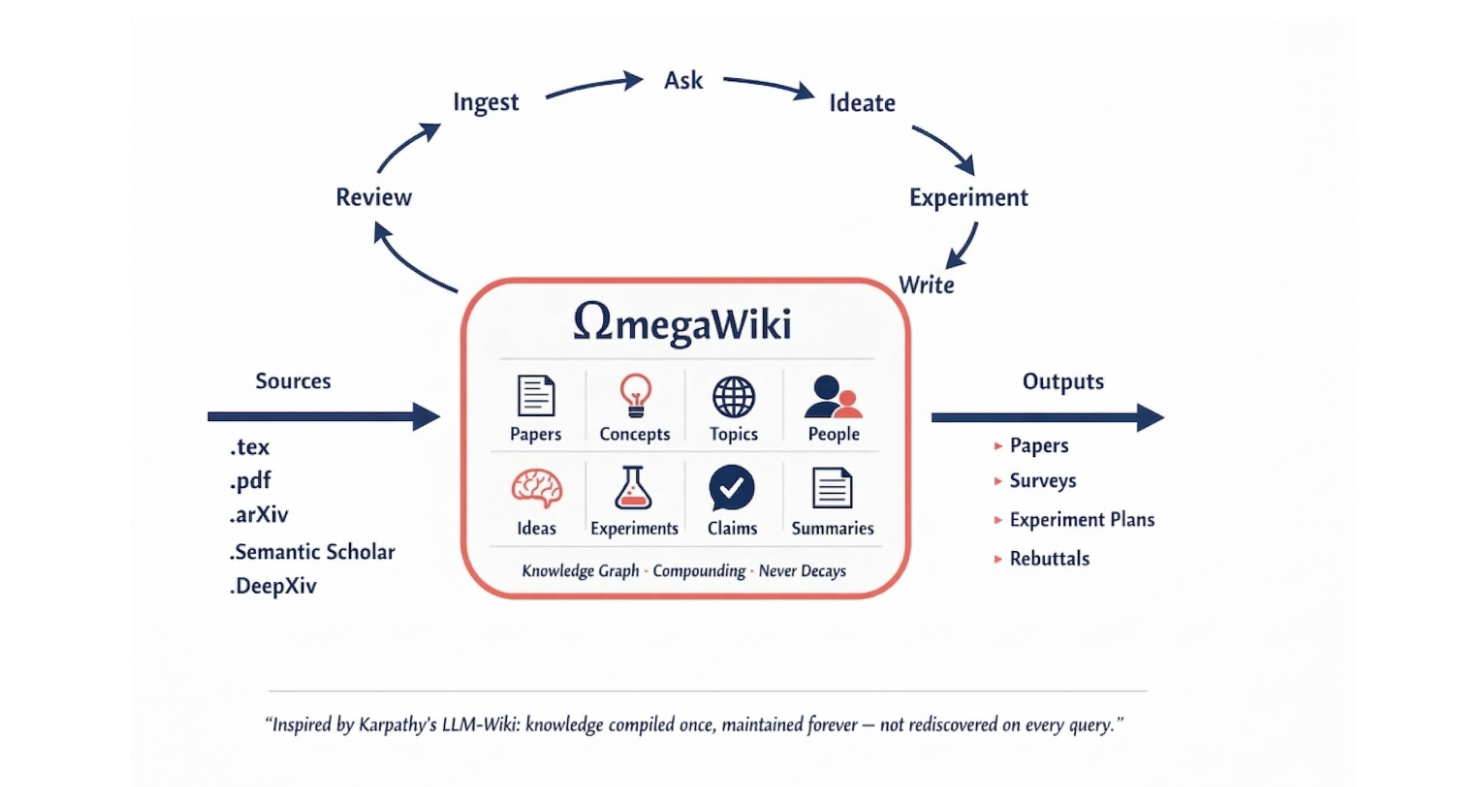
它怎么运作:原始素材、编译后的 wiki 与 Schema 层
这套架构有三层:
原始素材(Raw sources)——你的 PDF、文章、会议纪要、书签。它们原封不动,你只管往里丢。
wiki——一个由 LLM 撰写并维护的 markdown 文件目录。摘要、概念页、实体页、交叉引用都在里面。LLM 会在页面之间建链接、在新信息进来时标出矛盾、在你加入新东西时更新早期条目。
Schema——一个配置文件(Karpathy 用的是 CLAUDE.md),告诉 AI 怎么组织 wiki、怎么吸收新素材、怎么格式化答案。这是让整套系统保持连贯的操作手册。
人的工作,是决定什么东西该进、并问出好问题。记账的事交给 LLM。这个分工就是整个想法的全部。
它和 RAG、传统笔记法有什么不同
RAG 做检索。LLM wiki 做_积累_。这才是真正的区别。
Notion 或 Obsidian 这类传统笔记应用给你一个容器,但所有维护都留给你——你得自己打标签、自己连链接、自己更新。多数人的 Notion 数据库里塞满了第二个月起就再没人碰过的页面。LLM wiki 把维护问题外包出去解决了——交叉引用、过时信息标记、连接自动更新,全交给 LLM。
正如 Analytics Vidhya 对 Karpathy 方法的拆解所解释的,每新增一份素材,wiki 都变得更值钱,因为每一次吸收做的是整合(integrate),而不只是追加(append)。
Karpathy 的做法为什么爆火
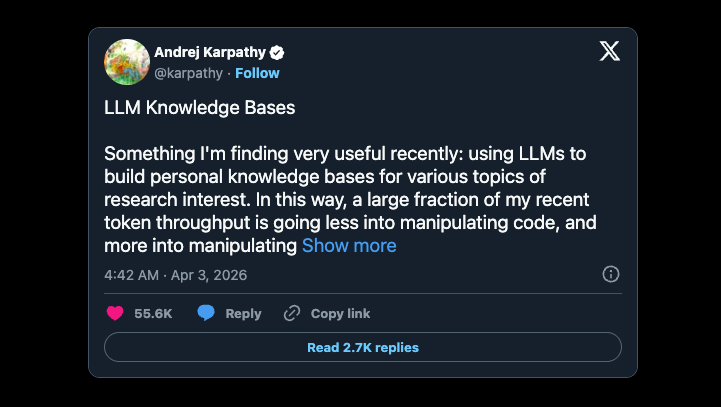
那条推文拿到 1600 多万浏览量,跟进的那份 gist 几天内超过 5000 星。对一份架构文档来说,这不是正常表现。
我认为它火有两个原因。其一,它给人们早就有的、却说不出口的挫败感命了名。「每次从零重新发现」的问题是真实的、烦人的,此前没人给它一个干净的框架。其二,它不是代码,而是一份「idea file」——一个你贴进自己的 LLM Agent、让它替你铺开的概念模式。这让它显得立即可用,而不是遥不可及。
核心洞见:会复利的知识,而不是会清零的知识
让我停下来的,是这句话。
出自 Karpathy 的 gist:「维护知识库最枯燥的部分不是阅读,也不是思考——是记账。人类放弃 wiki,是因为维护负担的增长快于价值的增长。而 LLM 不会无聊。」
就是这句。这就是全部洞见。每个个人知识系统最终都会崩塌,原因不是人们停止阅读——而是没人愿意把周六下午花在 Notion 里更新交叉引用上。LLM wiki 不要求你做这件事。LLM 会做那一部分,无限期地、以近乎为零的边际成本。
从_你来_维护系统,到 _LLM 来_维护它——这个转变其实是个相当重大的框架重构。
Farzapedia——把它用在自己的私人上下文时会发生什么
这次爆火中最有意思的真实案例不是 Karpathy 的研究型配置,而是 Farzapedia。
开发者 Farza 把 2500 条记录——日记、Apple Notes、iMessage 对话——喂进一个 LLM,让它编译出一份「个人维基百科」。结果得到 400 篇互相链接的文章,覆盖他的朋友、公司、项目与兴趣,全文布满反向链接与交叉引用。
Karpathy 转发并评价这件成品「显式、可导航」。重点不在于这份 wiki 比原始笔记_知道得更多_,而在于它可以被「走」——你真能去导航它、找到东西、顺着连接走下去。原始笔记是一堆;wiki 是一张地图。
这个案例很重要,因为它说明这个模式远不止学术研究适用。它适用于_任何_随时间积累知识的领域。而多数知识工作正是如此。
它实际上为谁而建
这里我想直接说,因为我见过的大多数文章都跳过了这段。
**Karpathy 的实现是给开发者的。**没有例外。
他的配置需要 Claude Code(一个基于终端的编程 Agent)、Obsidian、熟悉 shell 命令、熟悉 GitHub gist,以及出问题时愿意调试的心态。Antigravity 对 LLM Wiki 这个 idea file 的深挖逐个工具讲得很细——而那份清单,对非技术人员来说相当劝退。
这不是对那个模式的批评,只是如实陈述。Karpathy 是一名研究者兼工程师,在为他_自己_的工作方式搭系统。他的语料是论文、代码和研究文档,他的工作流是「一个 shell + 一个 LLM」。
研究者、开发者——vs 单人业务运营者
「这东西为谁而建」与「谁在为它兴奋」之间的落差相当大。
单人创始人、内容创作者、顾问、运营人员——他们读到推文、为核心洞见兴奋,然后打开那份 GitHub gist、看到一堆终端命令。大多数人就在这一步停了。
那个洞见对任何长期处理大量信息的人都有真实价值。但那个实现假设了某种技术熟练度,是多数非开发者不具备、也不愿意仅仅为了管笔记去学的。
我处在中间。我能看懂这套架构,但我不想在某个本该写作的周二下午去调试一个 Python 脚本。
单人创业者不建任何东西,也能从这个模式学到什么
Karpathy 模式里适用于所有人的部分不是工具,而是底层原则。
它解决的底层问题:上下文丢失与重置成本
每当你打开一个新的 AI 会话、不得不重新解释你的项目、你的上下文、你的偏好、你的标准——那就是一次重置成本。单次不大,但在几百次会话里复利累积。
LLM wiki 通过让知识_持久而显式_来解决它:AI 在 wiki 里导航,而不是从零开始;人做策展,而不是反复解释。
对不打算建 markdown 目录和 schema 文件的单人创业者,同样的原则在一个更简的层面照样成立:「编译一次、多次使用」最便宜的形式是什么?
可能是一份你持续维护更新的结构化系统提示词;一份在关键工作流开头贴进去的参考文档;一个编码了你工作方式、让你不必每会话都重新解释的模板。机制更简单,复利却是真的。
工作区优先的路线覆盖了什么
还有一个正在兴起的产品品类,想更直接地为非开发者解决这个问题——围绕「工作区」模型而不是「助手」模型构建的工具。
思路是:不是每个会话都由你把上下文带给 AI,而是让 AI 住进一个你的工作_本来就在那里_的环境。文件、浏览、决策、迭代式编辑——上下文在那里积累,不需要你管理。
Floatboat AI 之类的工具正在朝这个方向建——一个随时间学习你工作模式、而不是每会话从零开始的工作区。我还没拿足够多的真实工作流跑过它,给不出定论,但这个框架与 LLM wiki 所指的问题是同一个:让上下文复利,而不是重置。
你该不该自己建一个 LLM wiki?
我给你一个真正的答案。
什么时候「该」成立
如果你是开发者、或对终端很熟,工作对象是一套随时间增长、边界清晰的语料(研究、文档、客户文件、你长期报道的一个领域),而且你会经常性地吸收新素材、让维护投入回本——那就建一个。
这个模式对研究者、技术写作者、领域分析师,以及任何工作涉及「逐步吃透一个复杂主题」的人都闪闪发光。如果你有 50 份以上的素材、而且还在源源不断地来,一份编译好的 wiki 会随着它长大,替你省下越来越多的时间。
什么时候「不值当」
如果你不搞技术,搭建成本是实打实的。你需要 Claude Code 或同类 Agent、熟悉 markdown 与 shell 命令、还愿意去调试。那份 gist 很精彩,但对新手并不友好。
如果你的知识库很浅(不到 30–40 份素材),或者你做的是五花八门的临时工作、而不是深度的领域积累,这笔投入多半回报不足。一份维护良好的系统提示词加几份参考文档,能覆盖同样的需求,而零基础设施。
适合单人创业者的更轻替代
对非技术用户,有几个现实选项:
最简版本:维护一份活的「上下文文档」——用 500–800 字描述你当前的项目、工作偏好与标准。在重要的 AI 会话开头贴进去,每月更新一次。不如编译好的 wiki 强,但解决的是同一个重置问题,而且十分钟就能搭好。
中间档:Notion AI 或 ChatGPT 的记忆功能这类工具提供部分版本化的持久上下文——它们能在不同程度上跨会话记住东西。不如 wiki 结构化,但摩擦低得多。
新兴品类:Floatboat这类工作区工具正在尝试让「上下文复利」模式无需任何搭建即可获得。值得随着品类成熟持续关注。
Karpathy 模式指向的产品品类
那份 gist 自己就暗示了这一点。Karpathy 提到,随着这个模式成熟,会有一个「不可思议的新产品」的空间——把吸收、查询、lint 与可视化做成一个连贯的东西,而不是一堆脚本。
眼下社区已经在快速迭代——给 wiki 页面加置信度评分、当新素材与旧素材矛盾时做 supersession 逻辑、做生命周期管理让知识不腐坏。这些是规模化之后才会浮现的问题,而且正在被公开解决。
开发者社区今天手搓的东西,很可能就是产品团队在未来 12–18 个月打磨成成熟软件的东西。模式已经清楚,剩下的基础设施问题只是:谁来把它带给另外那 95% 不会跑 shell 的用户?
这就是 LLM wiki 所指的产品品类。不是更好的 RAG,而是一个懂你怎么工作的工作区。
以上就是我对这件事目前的看法。这个模式真的很有意思——不是因为它颠覆了什么,而是因为它终于把问题讲清楚了,还给了它一套具体的架构。要不要自己建一个,几乎完全取决于两件事:你是否习惯跑 shell 命令,以及你的工作是否真的涉及随时间推移的深度领域积累。
如果两个答案都是「是」:Karpathy 的 gist 就在那里,社区实现也已经相当可用。
如果任何一个答案是「否」:那个原则仍然重要。找到你自己的「编译一次、多次使用」的最简版本——那才是值得保留的部分。
往期文章
常见问题
什么是 LLM wiki?
LLM wiki 和 RAG 有什么不同?
Karpathy 的 LLM wiki 为什么会火?
非技术背景能搭建 LLM wiki 吗?
不想自建的话,最简替代版是什么?
我该不该自建一个 LLM wiki?
https://floatboat.ai/zh/blog/what-is-llm-wiki